AI 开发平台 · 大模型API与推理 端侧免费开箱即用
LFM3 Omni 2B WebGPU
Liquid AI 推出的端侧浏览器多模态模型空间,利用 WebGPU 实现设备端实时语音理解与低延迟流式响应。
免费额度与规则说明
通过现代浏览器 WebGPU 硬件加速,模型权重直接在本地设备显存中运行,无任何服务器费用。
功能深度解析与特色
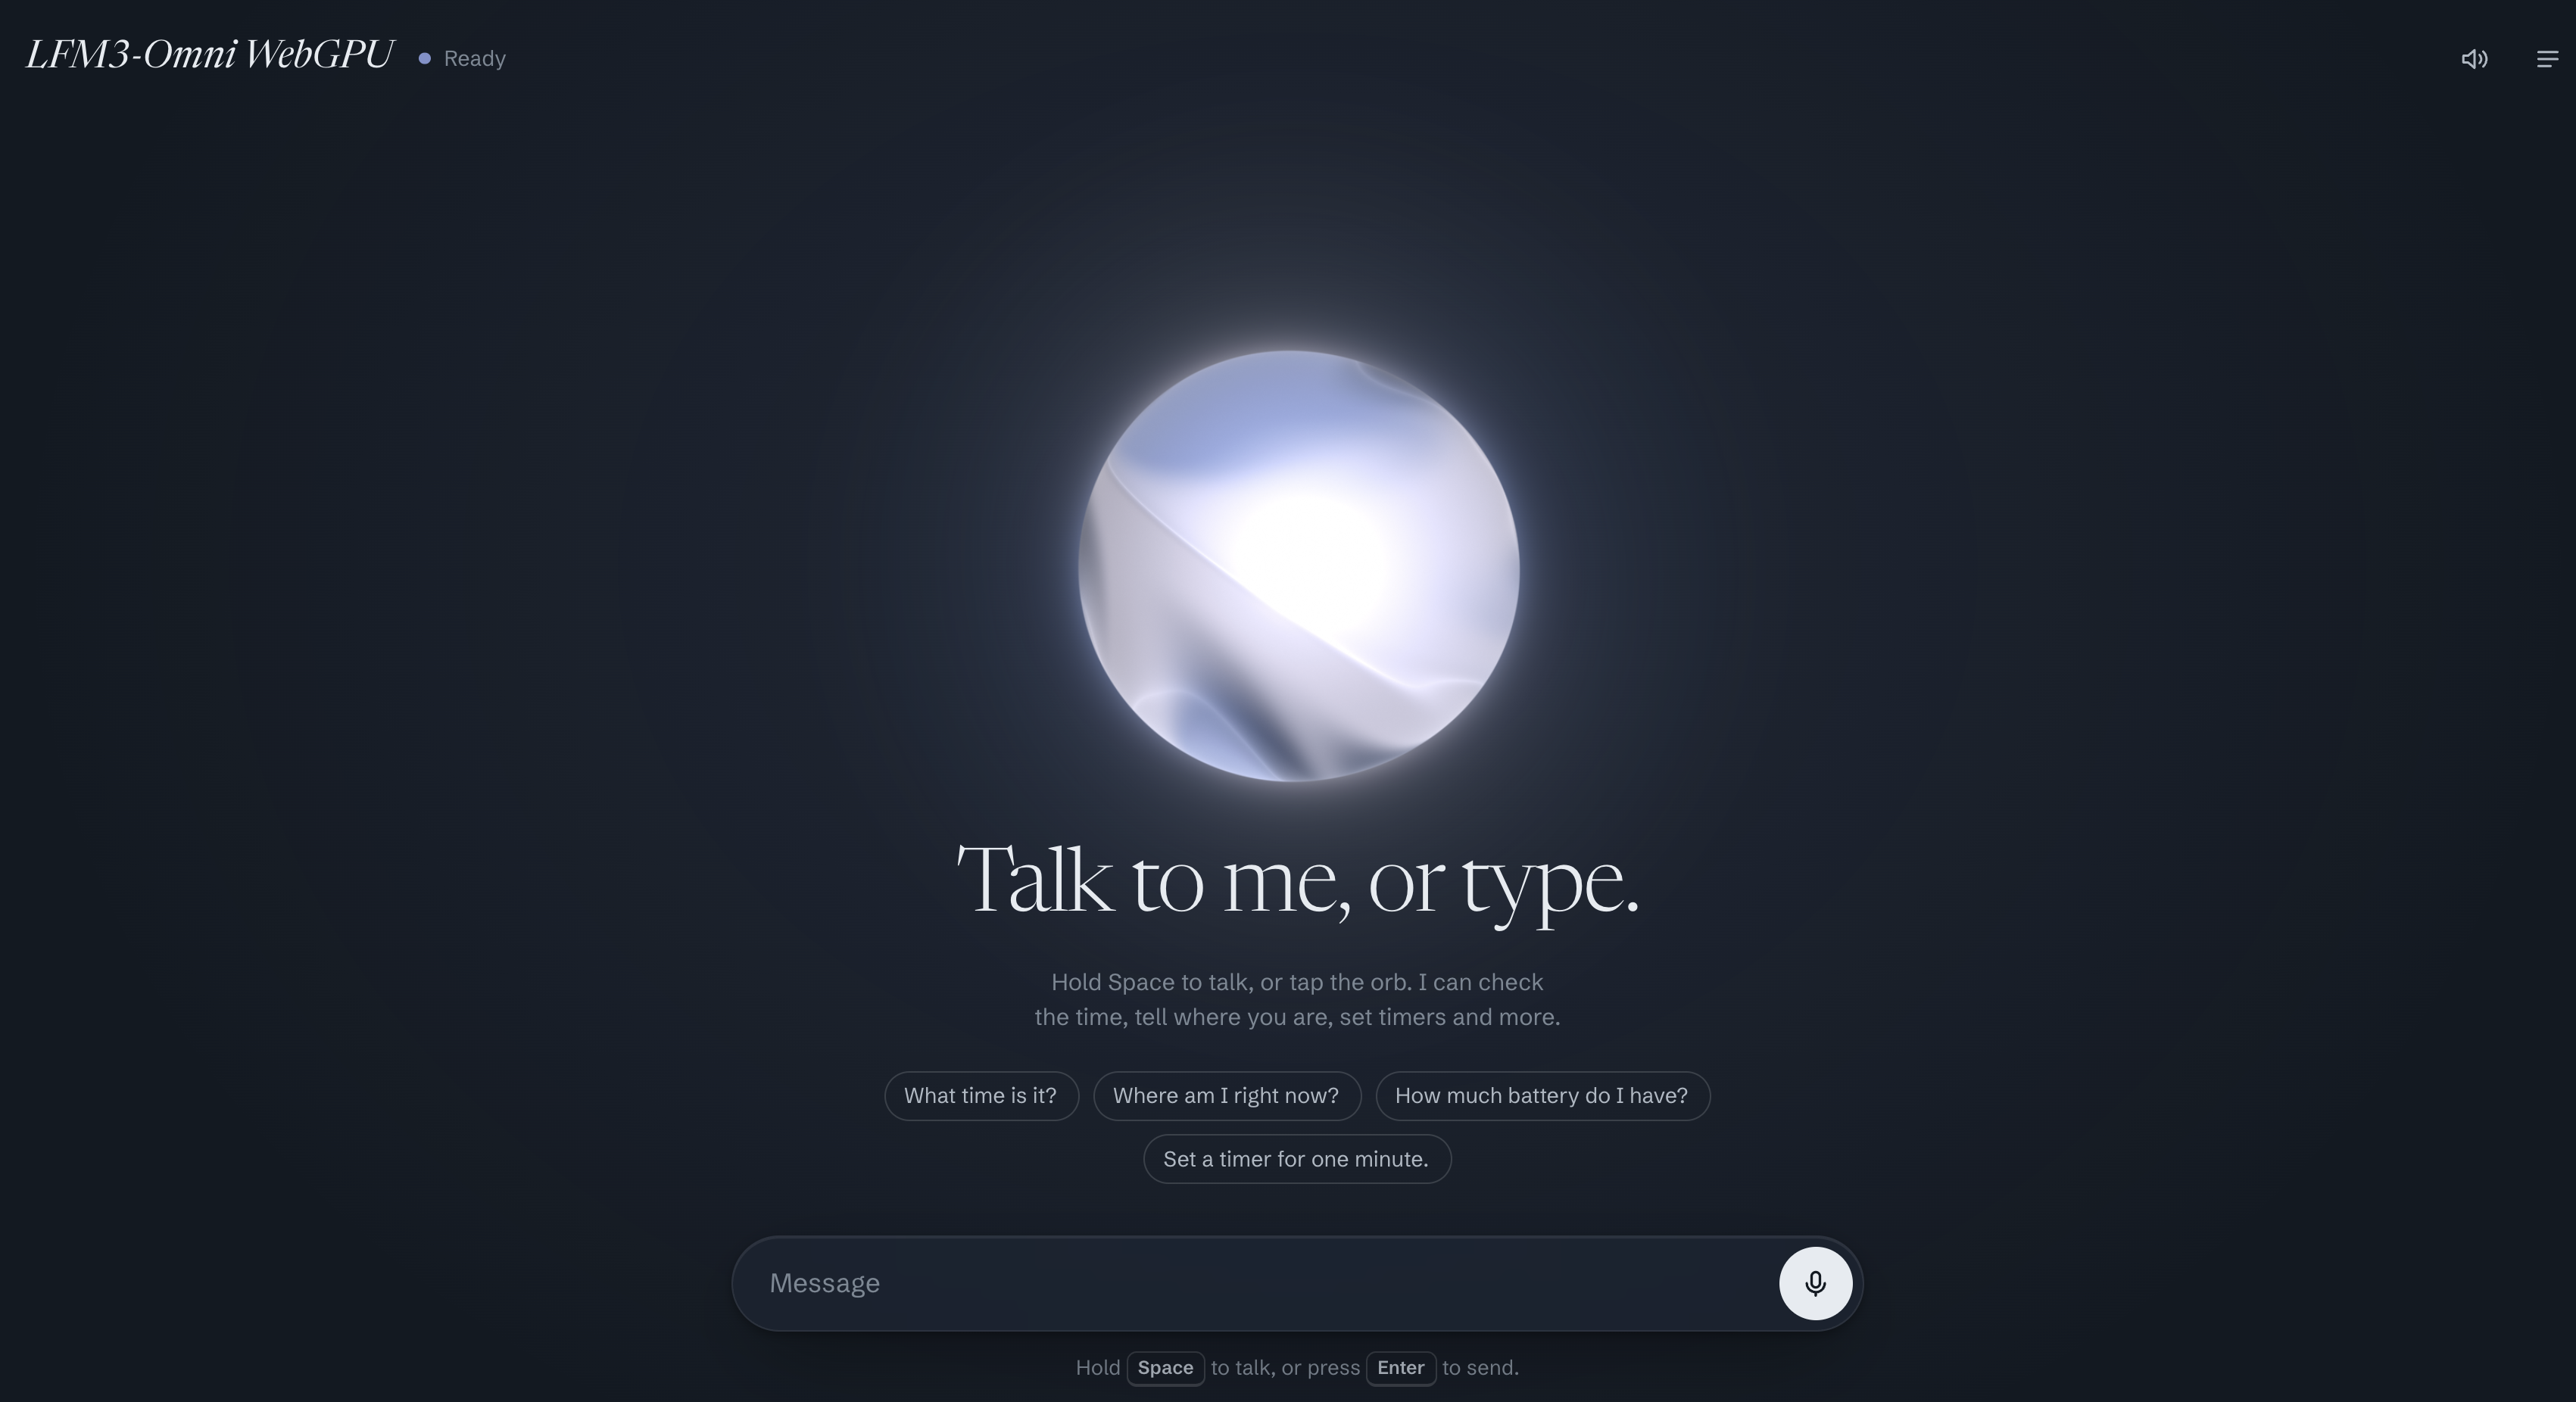
LFM3 Omni 2B WebGPU 是由前沿架构探索者 Liquid AI 联合开源社区打造的革命性端侧多模态交互实验场。过去的多模态全能大模型无一例外需要昂贵的数据中心 GPU 云端集群承载,不仅吞吐开销庞大,还伴随着跨境网络延迟与严峻的隐私外泄风险。得益于非 Transformer 动态液体神经网络架构的高能效比,该模型成功将 20 亿参数端侧多模态权重整体载入浏览器中,通过标准 WebGPU 直接调度本地显卡核心完成语音、文本与视觉的实时交互理解,开启了真正零云端依赖的端侧多模态新篇章。
界面实测与功能预览
小可实测优缺点评估
优势亮点
- 100% 运行在本地设备浏览器显存中,对话与音频绝对不出本机
- 利用标准 WebGPU 硬件加速,跨平台免驱动免配置即开即用
- 前沿液体神经网络架构,同等参数规模下具备更强端侧推理能效
注意事项与限制
- 首次载入需要从 Hugging Face 缓存下载约 2GB 模型权重文件
- 需要使用支持 WebGPU 的最新版本现代桌面浏览器与独立显卡